OCR 电子书之我见
- 2026-11-13 19:39:24
QUOTE
「跨页衔接是个问题,校对起来还是很繁琐,而这些事情理应全自动执行。」
在《光学字符识别?也学点新的》[1]一文中,我提到了使用 Gemini CLI 自动化处理 OCR 任务的方法。那时候还有 Gemini CLI(现在我用 Antigravity),那时候还没有 Skill(我把工作流写在系统提示词里)。虽然处理结果不尽如人意,但也是一番心意。
之后,我在小红书评论区的指引下走了 PaddleOCR 之类专业的弯路。效果令人满意,但跨页衔接是个问题,校对起来还是很繁琐,而这些事情理应全自动执行。
最近 Gemini 接连推出了好几个 Flash 模型,可以重启这个全自动 OCR 项目了,直接写成一个 Skill:pdf-book-ocr[2]。
文中使用模型均为 Gemini 3.8 Flash,使用 Agent 均为 Antigravity。
01
PIPELINE
PDF → EPUB
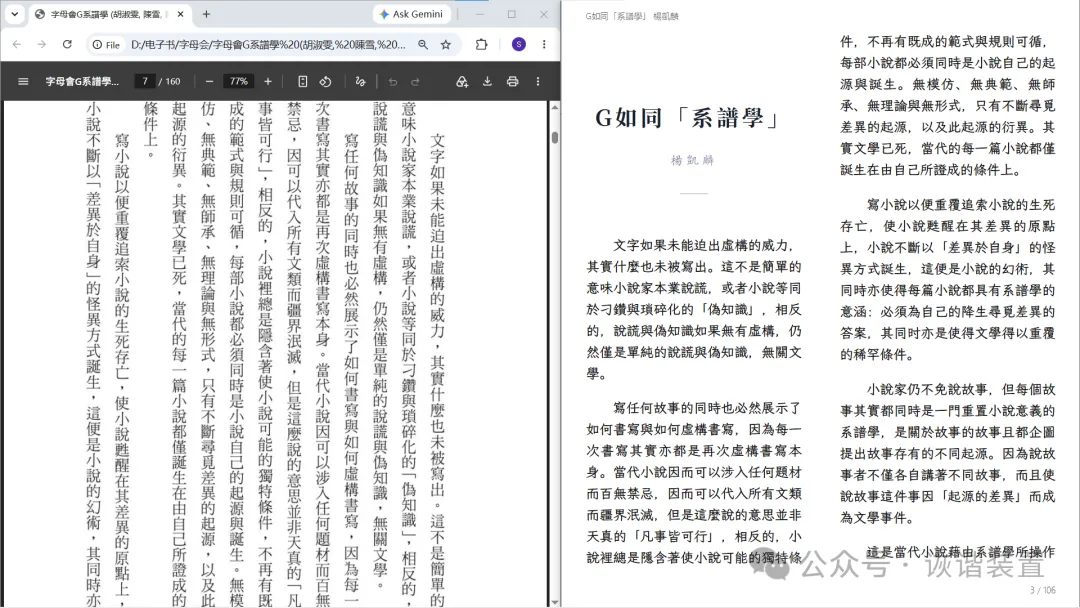
输入是原始 PDF,输出是规范排版的 EPUB。
和之前的翻译器 TransLit[3] 一样,
「我需要一个好的成品,但完全不需要保持最初的排版。」
工作流很自然,重要的几步大致是这样:
切分 PDF;
子 Agent 分批并行 OCR;
合并内容;
Markdown 转 EPUB。
还有一些处理细节,可能不太值得详细写,比如:
数字版 vs 扫描版
数字版 PDF 不同于扫描版 PDF 的处理流程;
标题层级控制
在分派子 Agent 前限定大标题,在转 EPUB 之前检查全部标题层级;
过滤冗余页面
删除版权信息等页面——反正 PDF 主要是盗版。
附上 Agent 绘制的流程图,以供参考:
[原始 PDF 图书]
│
▼ (Step 1: 预处理、切片规划与全局目录提取)
digitize_book.py ──> 提取封面与物理切片
│ 主 Agent 审视卷首切片提炼《全书大章白名单》
▼
[Gate 1 门禁] ──────> 确认清单条目有效 + 大章白名单已提取
│
▼ (Step 2: Subagent 批次滚动转写)
invoke_subagent ───> 注入【全书大章白名单】,防局部视界导致的小节升格
│ 逐片落盘 raw_md/*.md
▼
[Gate 2 门禁] ──────> 确认切片 100% 完整落盘且 > 100B
│
▼ (Step 3: 汇编与目录审查门禁)
digitize_book.py --preview-toc (可选快速预检)
digitize_book.py --assemble
├── seam_auditor: 跨切片接缝平滑焊接 (12 MERGE / 11 SPLIT)
├── toc_manifest: 导出章节拟案,高亮微短章与英文单词孤岛
│ └── [Gate 3 门禁]: 主 Agent 对照大章白名单,核验无碎片短章后再放行
├── chapter_assembler: 依真实大章聚合,隔离脚注命名空间
└── epub_builder: Pandoc 编译 EPUB 3 + 注入双向弹框注释
│
▼ (Step 4: 出厂验收)
《书名》.epub + 《书名》.md + images/ (生成至输出工作目录)
02
FIGURE EXTRACTION
插图的处理方式
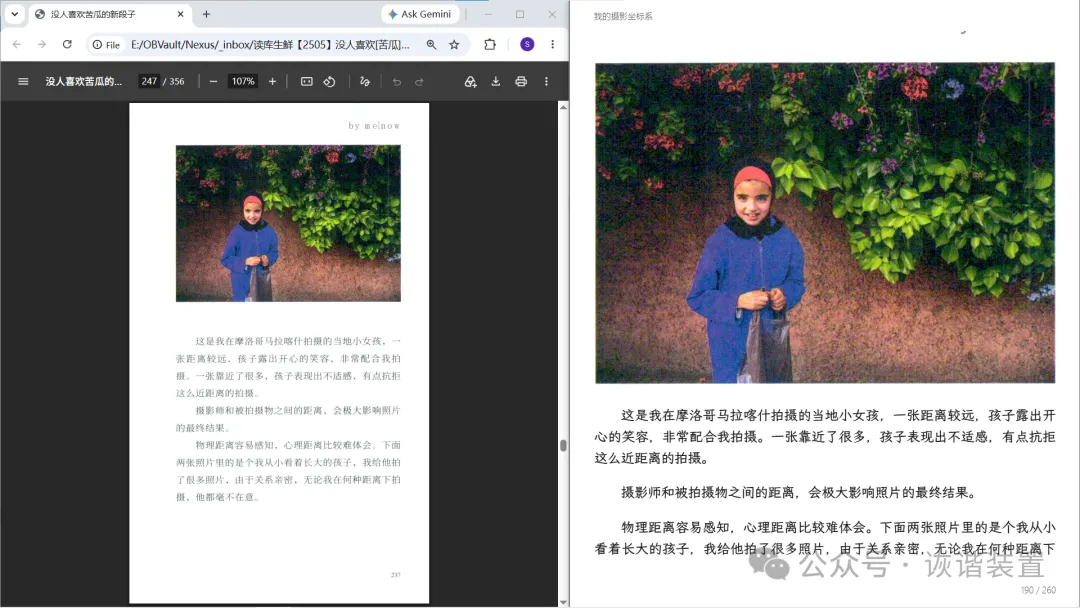
之前在 Google AI Studio 窗口做 OCR,自是只能处理小说之类的“字书”。Paddle OCR 等工具倒是可以理解排版,保存截图到合适的位置。
用上 Agent 之后,就有了更好的处理思路。
在子 Agent 做 OCR 的同时,遇到插图就会记录类似于这样的标记:
<!-- FIGURE: page=3 bbox=[150, 80, 520, 920] -->

其中包括插图的页码、位置(上下左右坐标)、图题以及占位用的文件名。
当全部子 Agent 转写完毕之后,调用脚本在 PDF 中相应位置截图并保存。
ALGORITHM
这个脚本还有一点数字图像处理的思路,AI 说这叫 投影轮廓吸附(Projection Profile Snapping)——先在大模型给出的坐标基础上外扩一圈,防止图像不全;之后做边缘检测(为了不把图题截下来,还会检测图题和图像中的空白缝隙),删去白边。
∞
EPILOGUE
结语
如果效果不满意,可以在任务完成之后和 Agent 交流改进。
有快要过期的余量的话,这个 Skill 值得一试。
参考链接:
[1] 光学字符识别?也学点新的:https://fengyukongzhou.github.io/2025/09/07/OCR-Gemini/
[2] pdf-book-ocr 仓库:https://github.com/fengyukongzhou/pdf-book-ocr
[3] TransLit 翻译应用:https://ai.studio/apps/b184f80d-4fa5-4fce-a431-029da0140dce
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
 微信扫一扫 · 添加人工客服
 QQ扫一扫 · 添加人工客服